Attention Sink Là Gì?
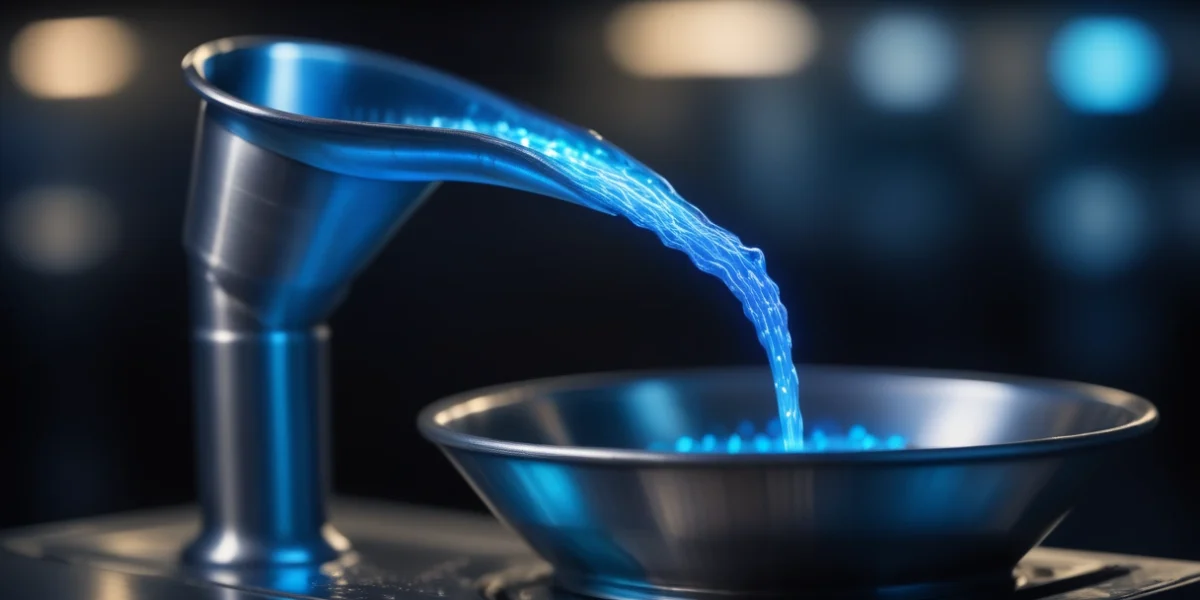
Attention Sink là hiện tượng mô hình ngôn ngữ cứ “đổ” một lượng attention khổng lồ vào vài token đầu tiên của câu, thường là token khởi đầu vô nghĩa, dù token đó chẳng mang thông tin gì. Các token này hoạt động như một cái “bồn chứa”attention, hút phần chú ý dư thừa để các token khác rảnh tay chú ý đúng chỗ cần thiết.
Thuật ngữ này nổi bật sau nghiên cứu của nhóm tác giả tại Đại học Cornell (2023), khi họ phát hiện nếu cắt bỏ token đầu câu khi xử lý ngữ cảnh dài, chất lượng của mô hình kiểu decoder-only như GPT giảm hẳn, dù theo logic thì token đó chẳng quan trọng.
Tại Sao Mô Hình AI Cần Attention Sink?
Cơ chế attention trong mô hình transformer yêu cầu tổng mức chú ý phân phối phải bằng một. Nghĩa là mọi token bắt buộc phải chia chú ý của mình cho các token khác, kể cả khi chẳng có gì đáng chú ý. Kiểu như trong một buổi họp, mỗi người buộc phải nhìn về phía nào đó, kể cả khi không có gì để nhìn.
Khi phần lớn nội dung thực sự không liên quan đến token hiện tại, mô hình cần một chỗ để “trút” phần chú ý dư. Token đầu tiên, luôn xuất hiện và luôn được mọi token thấy được, trở thành ứng viên hoàn hảo cho vai trò này. Nó giống như trong buổi họp kia, mọi người cùng quay nhìn về góc phòng trống cho có lệ, để khỏi phải nhìn chằm chằm vào người khác một cách kỳ cục.
Attention Sink Gây Ra Vấn Đề Gì?
Vấn đề lớn nhất nằm ở việc cache. Khi mô hình sinh văn bản, hệ thống lưu KV Cache cho từng token để không phải tính lại. Token đầu câu giữ lượng attention khổng lồ nên bắt buộc phải giữ trong cache suốt phiên, và toàn bộ những token nối đuôi sau nó cũng bị giữ theo, dù gần như vô dụng.
Điều này khiến khả năng xử lý ngữ cảnh dài bị bó tay: dám xóa token “rác” để tiết kiệm bộ nhớ thì mô hình nhiễu liền. Đây chính là rào cản mà kỹ thuật StreamingLLM ra đời để giải quyết, cho phép mô hình giữ lại các sink token ở đầu và cửa sổ trượt ở cuối, nhờ đó xử lý được văn bản hàng triệu token với cache ổn định.
Cách Xử Lý Attention Sink Trong LLM?
Có ba hướng chính. Một là giữ nguyên sink token và loại bỏ phần giữa, như StreamingLLM kể trên. Hai là huấn luyện mô hình từ đầu với một token chuyên làm sink, ví dụ token || bắt đầu văn bản, để mô hình có chỗ trút chú ý hợp lệ ngay từ đầu. Hướng này được dùng trong các mô hình như Gemma 2.
Ba là cải tiến cách tính attention để mức chú ý không bắt buộc cộng về một, giúp mô hình tự do bỏ qua phần không liên quan thay vì trút vào sink. Mỗi hướng đánh đổi khác nhau về chi phí huấn luyện và hiệu quả, nhưng tất cả đều nhằm một mục tiêu chung: để ngữ cảnh dài rẻ hơn và ổn định hơn.
Attention Sink Liên Quan Gì Đến Người Dùng Thực Tế?
Nếu bạn từng thắc mắc vì sao ChatGPT hay các chatbot chạy local như LM Studio hay Ollama duy trì được cuộc hội thoại dài mà không “nổ” bộ nhớ, thì một phần công lao thuộc về các kỹ thuật xử lý attention sink. Máy chủ tiết kiệm được phần lớn KV Cache, qua đó phục vụ nhiều người dùng hơn với cùng một cụm GPU.
Với người tự chạy model trên máy cá nhân, hiểu về sink giúp chọn chiến lược cache hợp lý: thay vì cắt ngữ cảnh kiểu “cửa sổ trượt thuần túy” bỏ luôn đầu câu, hãy giữ vài token đầu. Chi tiết nhỏ này đôi khi giữ nguyên chất lượng trả lời trong hội thoại hàng chục nghìn token.
Nói rộng hơn, attention sink là một ví dụ điển hình cho việc mô hình AI học những “mẹo vụn” mà chính người tạo ra nó cũng không lường trước, và chỉ phát hiện được khi soi kỹ cơ chế attention bên trong. Đây chính là tinh thần của dòng nghiên cứu interpretability, mổ xẻ hộp đen AI để hiểu nó thực sự nghĩ gì.
Kết Luận
Attention Sink là hiện tượng mô hình dồn attention vào vài token đầu câu như một cái bồn chứa, để né ràng buộc phân phối chú ý phải bằng một. Hiện tượng này gây lãng phí bộ nhớ cache khi xử lý ngữ cảnh dài, nhưng cũng mở ra các giải pháp như StreamingLLM hay token sink chuyên dụng. Với người làm sản phẩm AI, nắm được khái niệm này giúp tối ưu cache và chi phí phục vụ. Còn với người tò mò, nó là minh chứng sống động rằng bên trong AI vẫn còn đầy những điều bất ngờ đang chờ được lý giải.